Decision Model Jev
分类:Decision Model / SFT;训练 ¥12.36;五项平均准确率 76.30% → 83.46%
Jev 是什么?
Jev 这类模型可以理解为:一个拥有通用世界知识的分类决策模型。给它一段状态(state)和一组带固定选项的问题(questions),它回答“选哪一项,各自有多大把握”。
企业里有大量场景,选项本来就是固定且有限的:
- 意图理解:从退款、换货、咨询等预设类别中判断用户诉求;
- 工单路由:决定一条消息交给账单组、物流组还是技术组;
- 风险分级:判断低风险放行、中风险复核或高风险拦截。
在源仓库保存的 OpenRouter “Top models by task” 截图 中,Classification 占全平台花销的 10.4%,是 General 类别(31.2%)中最大的单一任务。这里引用的是该截图中的统计。
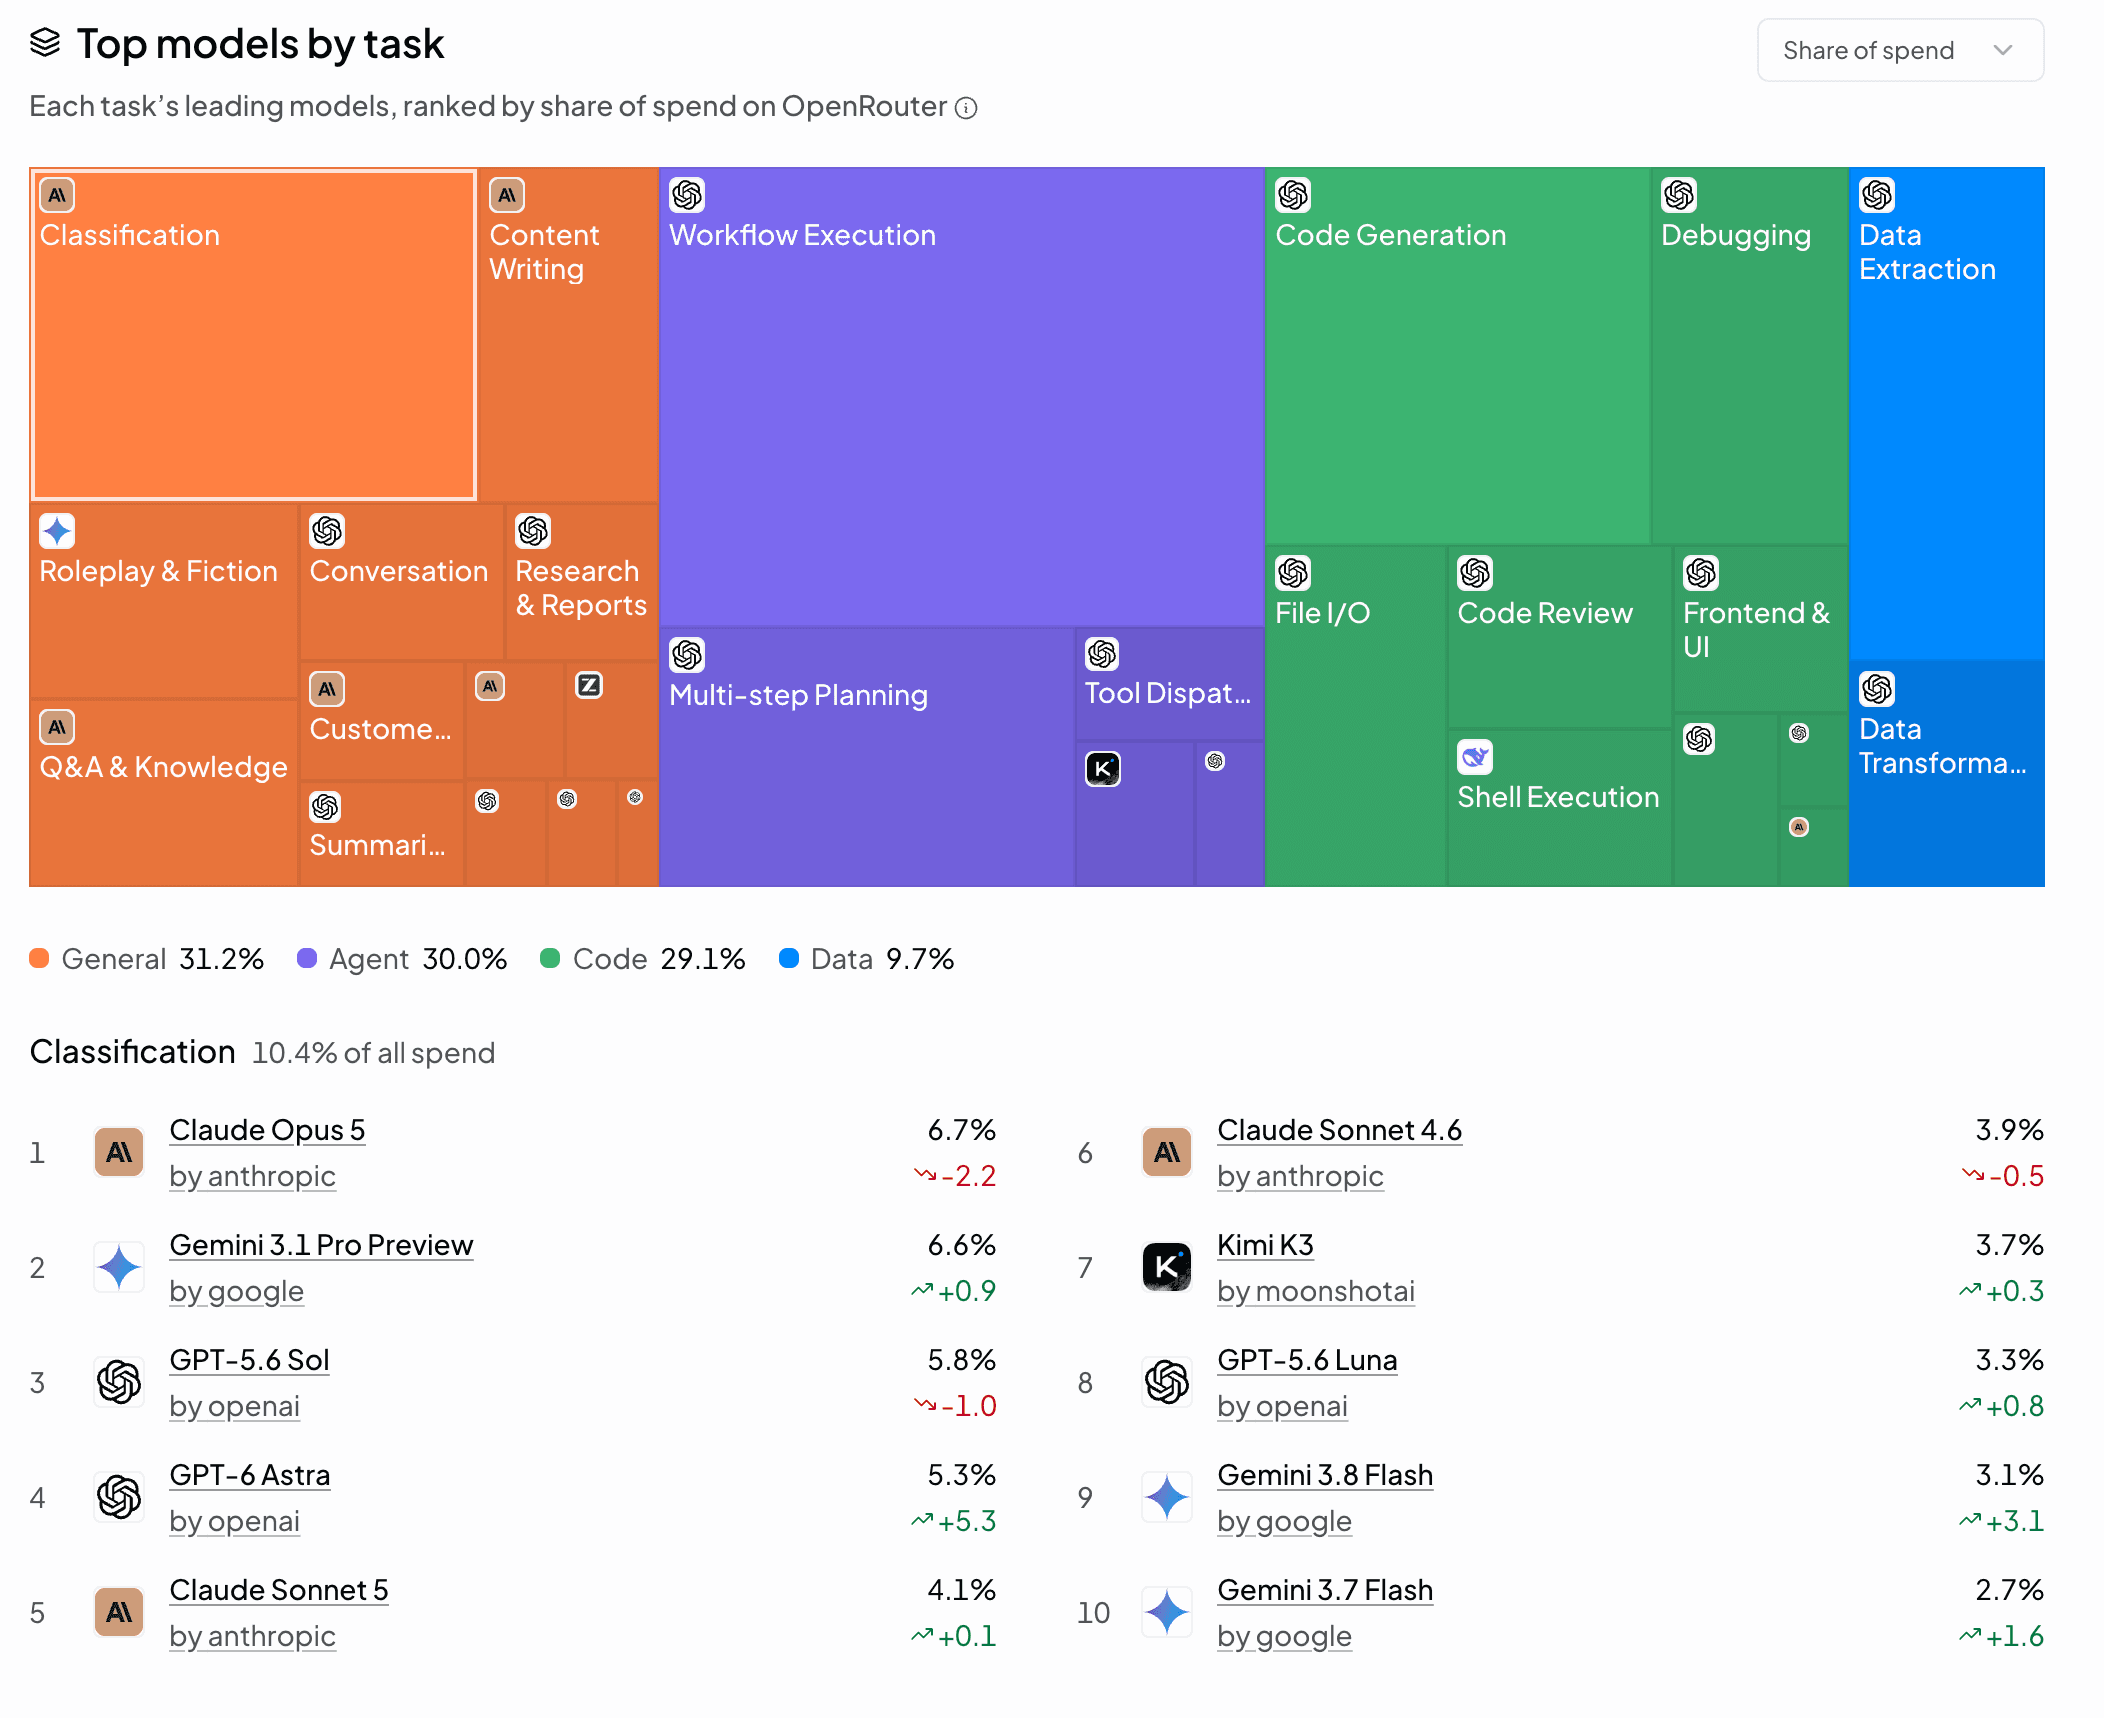
截图里,Claude Opus 5、Gemini 3.1 Pro Preview、GPT-6 Astra 等通用模型也在承担分类任务。对高频的固定选项决策,模型输出可以直接交给后续程序:按标签路由,按分数排序,或根据经过校准的概率设置人工复核阈值。
可以把 Jev 放在“快思考”的位置:专注于高频、固定、可枚举的路由与决策;通用模型的“慢思考”负责开放任务中的推理与规划。两者在同一条业务流程里配合使用。
下面通过一个完整案例,介绍如何用自己的数据训练这类决策模型,并评估它的准确率和概率可信度。
本案例的实现
代码出处与消耗
- 完整代码来自
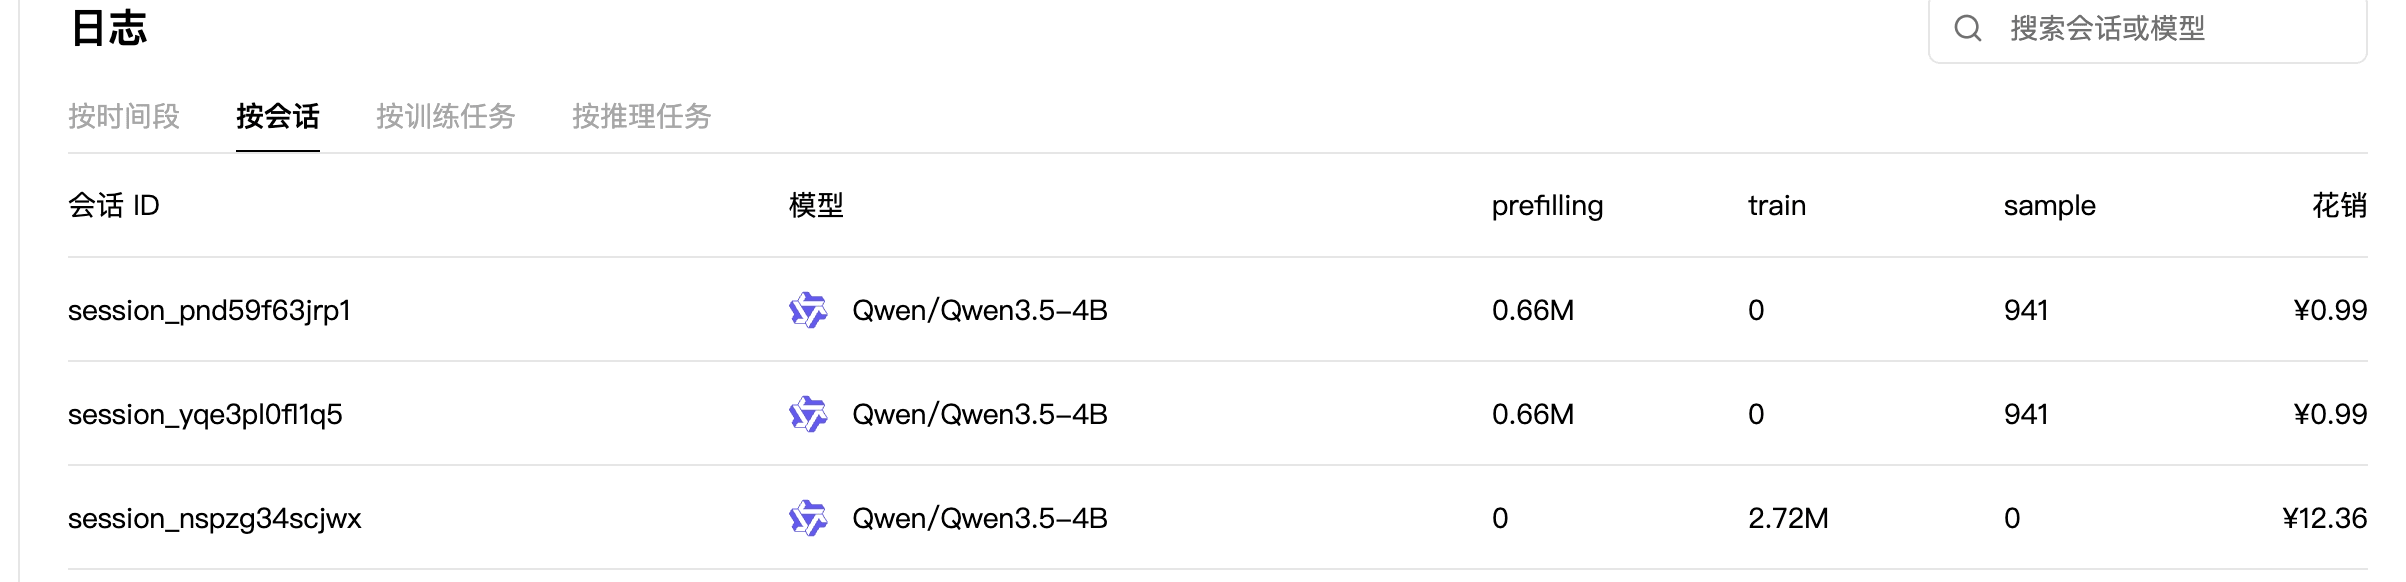
KMnO4-zx/agentic-rl-lab/09-pytrio-jev,本文核对版本为d2ba99c。正文中的源码链接固定到该版本。- 源仓库记录的 270-step 训练消耗 2.72M train tokens、¥12.36;费用截图另列两次评测,各 ¥0.99,三次会话合计 ¥14.34。这些是参考运行的记录,实际花销随输入长度、训练规模和评测次数变化。
- 训练曲线见 SwanLab 实验记录。本案例涉及数据编译、模板、训练、推理和校准多个模块,本文展示关键实现;可运行的全部文件请从源仓库获取。
本案例使用 Qwen/Qwen3.5-4B 和 PyTRIO,通过 LoRA 训练一个 Jev 风格的分类决策模型。输入包含共享的 state 和一组 questions,输出为每个字段的候选概率与决策结果,支持三种题型:
choice:从多个业务选项中选择一个;noul:判断 yes / no,并返回p_yes;score:返回各等级概率、最可能等级和期望分。
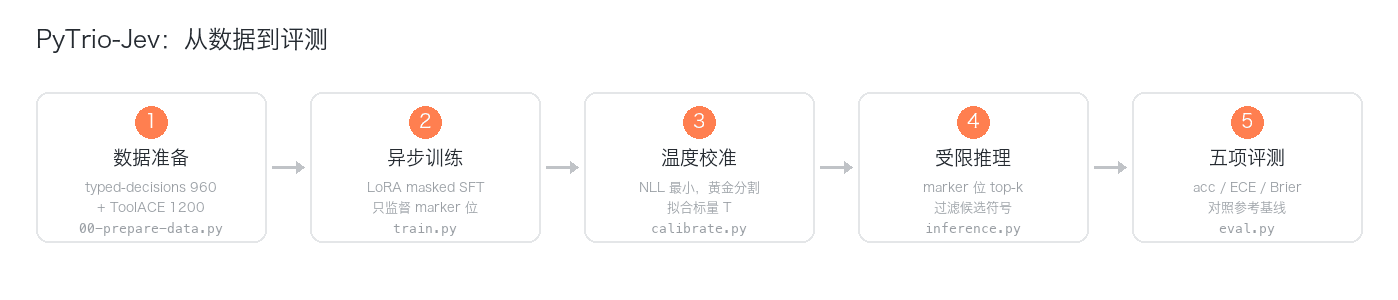
训练采用 cross_entropy:在含有占位符的 assistant JSON 骨架上,只监督各字段对应的答案符号。推理使用同一骨架,从 prompt logprob 中读取各字段的候选得分,再在本地归一化并映射回业务标签。
实验配置
| 项目 | 本案例配置 |
|---|---|
| Base Model | Qwen/Qwen3.5-4B |
| Python / PyTRIO | Python ≥ 3.13 / pytrio==0.2.9 |
| 训练方式 | LoRA masked SFT,rank 32 |
| 训练数据 | Typed Decisions 960 条 + ToolACE 1,200 条 |
| 决策题数 | 每个 epoch 共 6,000 个字段 |
| 训练规模 | 2 epochs,batch size 16,共 270 steps |
| Learning rate | 1e-4 |
| Loss | cross_entropy,仅决策位置的 weight 为 1 |
| Marker | 现有词表中的单 token decision |
| 校准集 | Typed Decisions 120 条记录 / 600 个字段 |
| Checkpoint | 每 60 step 和每个 epoch 结束保存 sampler weights |
代码结构
训练与推理依赖同一套数据协议。以下链接均直接指向 GitHub 源文件:
| 文件 | 职责 |
|---|---|
| 00-prepare-data.py | 下载数据、按案例切分、排除 ToolACE 评测请求 |
| data.py | 统一记录格式、候选映射、marker 定位和 Datum 构造 |
| templates/qwen3_5_jev.jinja | 训练与推理共用的本地 chat template |
| train.py | 异步 LoRA SFT、SwanLab 日志和权重保存 |
| inference.py | 读取候选 logprob、归一化概率和业务输出 |
| calibrate.py | 在 calibration 划分上拟合温度 |
| eval.py | 五项基准的 Accuracy、ECE 和 Brier 评测 |
| analysis.py | 汇总评测 JSON,生成 Markdown 对照表 |
| start.md | 完整启动命令 |
下面的 Python 片段摘自对应模块,需要在源工程上下文中阅读和运行。
环境与数据
本地负责数据准备、模板渲染、流程控制与概率处理;模型前向、反向和 LoRA 参数更新由 PyTRIO 远端执行。依赖以源仓库的 pyproject.toml 和 uv.lock 为准:
git clone https://github.com/KMnO4-zx/agentic-rl-lab.git
cd agentic-rl-lab
git checkout d2ba99ce6964f0525c0c0ab25dcefed50ee50e6b
uv sync --frozen
uv run trio login
uv run swanlab login
cd 09-pytrio-jev
后续命令均在案例目录中执行。运行 数据准备脚本:
uv run python 00-prepare-data.py脚本使用 LocalLLaMA/typed-decisions 和 Team-ACE/ToolACE,生成以下文件:
| 产物 | 内容 |
|---|---|
datasets/train.jsonl | 2,160 条记录,共 6,000 个决策字段 |
datasets/dev.jsonl | 120 条记录,留作 checkpoint 选择 |
datasets/calibration.jsonl | 120 条记录,仅用于温度拟合 |
datasets/eval/*.jsonl | Jevbench 三档、Typed Decisions test 和 ToolACE 五项评测集 |
Typed Decisions 按完整案例、按 workflow 切分,每个 workflow 取 240 / 30 / 30 条作为 train / dev / calibration。ToolACE 先排除与评测集请求文本匹配的记录,再采样 1,200 条训练记录。数据准备脚本没有固定上游数据 revision;严格复现时应保留下载后的 JSONL 和数据来源版本。
统一记录使用 state、questions 和训练标签 targets。下面根据 内置工单样例 保留一个字段,并按 数据编译协议 补入训练标签:
{
  "id": "ticket-1",
  "state": {"customer_message": "I was charged twice. Please refund the extra charge."},
  "questions": {
    "team": {
      "type": "choice",
      "instructions": "Which team should handle this ticket?",
      "criteria": {
        "billing": "Payments and refunds",
        "delivery": "Shipping and delivery",
        "technical": "Product technical support"
      }
    }
  },
  "targets": {"team": {"label": "billing"}}
}
推理时可以省略 targets。同一条记录可以包含多个字段,它们共享 state。
核心逻辑
1. 把业务选项映射为单 token 符号
question_options() 与 compile_record() 使用 A-Z a-z 0-9 作为候选符号表,最多表示 62 个选项:
| 题型 | 业务值到符号的映射 | 输出 |
|---|---|---|
choice | 按 criteria 字典顺序,例如 billing → A、delivery → B | 业务标签和各选项概率 |
noul | 固定 no → A、yes → B | yes / no 和 p_yes |
score | 列表索引从 0 开始,例如 0 → A、1 → B、2 → C | 等级、分布和期望分 |
三种题型都预测映射后的符号。score 使用字典时沿用字典的业务键,这些键须能转成整数,才能计算期望分。
训练标签只用于构造 target。assistant 输入始终保留 marker 骨架,下面是 compile_record() 的实现:
skeleton = json.dumps(dict.fromkeys(fields, MARKER), ensure_ascii=False, indent=4)
messages = [
    {"role": "system", "content": SYSTEM_PROMPT},
    {"role": "user", "content": user_text},
    {"role": "assistant", "content": skeleton},
]
真实答案不会写入输入骨架。训练和推理必须保持候选顺序一致;多个字段共用一个序列,但字段顺序仍会改变因果上下文,不应假定调换顺序后概率不变。
2. 用同一模板定位决策位置
Encoder.encode() 读取 本地 chat template,渲染 system + user + assistant,并保留固定的空 think 块。
decision 来自模型现有词表,Encoder 会检查它是否为单 token。定位时只扫描 assistant 骨架,跳过字段名里的同名 token。例如 ToolACE 的骨架可能包含 "decision": "decision",只有值对应的 token 才是决策位置。
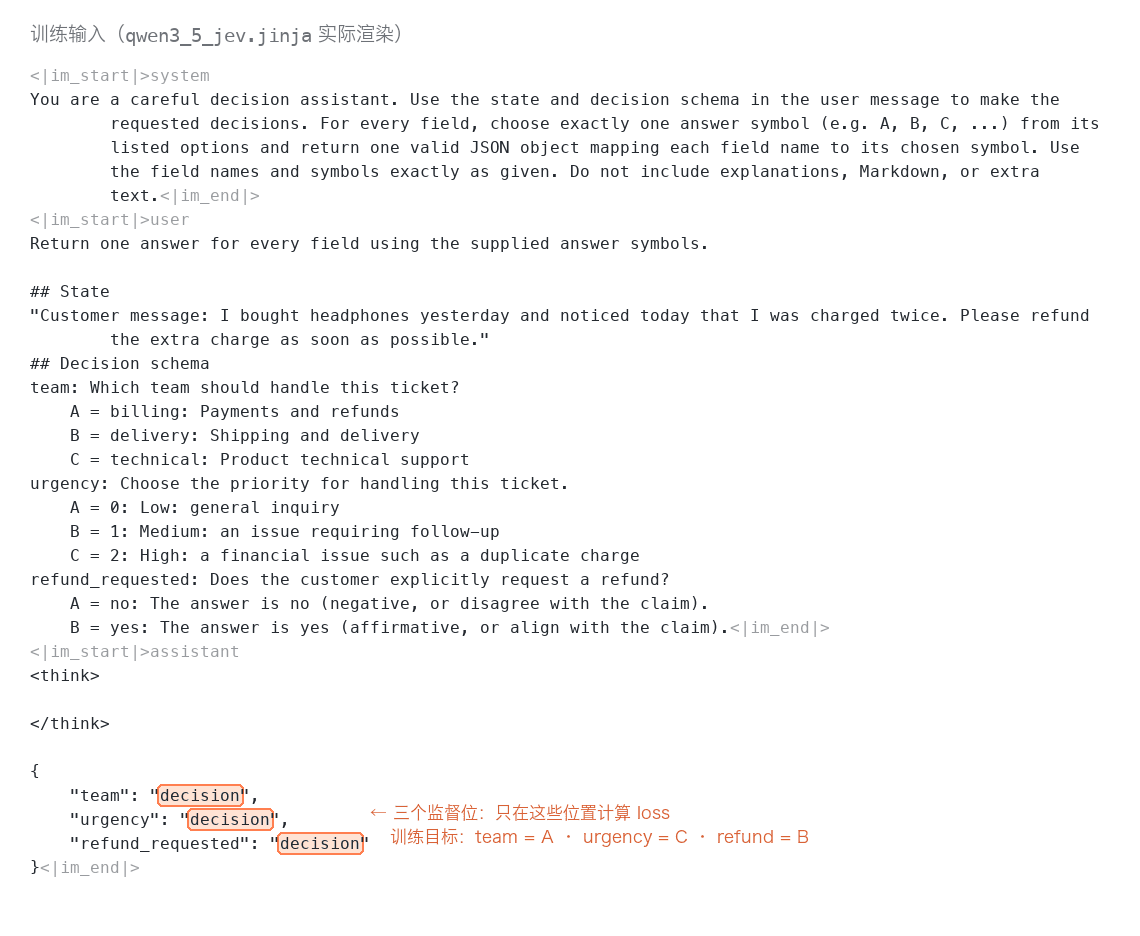
图中高亮的是 marker 在输入里的位置。设它的零基索引为 m,训练数组右移后,监督应落在 m - 1;推理返回的 prompt logprob 按被预测 token 的索引读取 m。
3. 只在决策位置计算交叉熵
Encoder.build_sft_datum() 保留完整输入,在右移后的 target 中替换正确符号,并只给对应位置非零权重:
encoded = self.encode(record)
ids = encoded["ids"]
target_tokens = list(ids[1:])
weights = [0.0] * len(target_tokens)
for field, symbol in encoded["targets"].items():
    position = encoded["markers"][field] - 1
    target_tokens[position] = self.symbol_token_id(symbol)
    weights[position] = 1.0
return trio.Datum(
    model_input=trio.ModelInput.from_ints(ids[:-1]),
    loss_fn_inputs={
        "target_tokens": np.asarray(target_tokens, dtype=np.int64),
        "weights": np.asarray(weights, dtype=np.float32),
    },
)这段代码位于方法体内。model_input、target_tokens 和 weights 严格等长,JSON 标点、字段名以及其他上下文位置的 weight 均为 0。一条记录有几个决策字段,就有几个监督 token;远端仍需处理完整输入序列。
4. 提交异步训练,按监督 token 记录 Loss
train.py 的训练循环 将每条记录构造成 Datum 后提交:
fwdbwd_future = await training_client.forward_backward_async(
    datums, "cross_entropy"
)
optim_future = await training_client.optim_step_async(adam_params)
两次调用返回的 future 由后台日志任务继续等待,保存权重和训练结束前会收齐 pending tasks。日志中的 loss = loss_sum / supervised_tokens,分母是实际决策位置数。
每条记录的字段数不同,因此相同 batch size 下的 supervised_tokens 会变化。当前训练循环丢弃不足一个 batch 的尾部;使用小数据集时应保证记录数至少达到 batch size。
5. 从 Prompt Logprob 读取候选概率
candidate_logprobs() 使用相同 Encoder,并关闭标签编译:
encoded = encoder.encode(record, include_targets=False)
response = sampling_client.sample(
    prompt=trio.ModelInput.from_ints(encoded["ids"]),
    num_samples=1,
    sampling_params=trio.SamplingParams(max_tokens=1),
    include_prompt_logprobs=True,
    topk_prompt_logprobs=max(len(opts) for opts in encoded["options"].values()),
).result()
一次请求读取全部字段的 prompt logprob。额外生成的 1 个 token 不参与决策;候选提取函数 先检查本地与远端输入长度一致,再读取 response.topk_prompt_logprobs[m]。
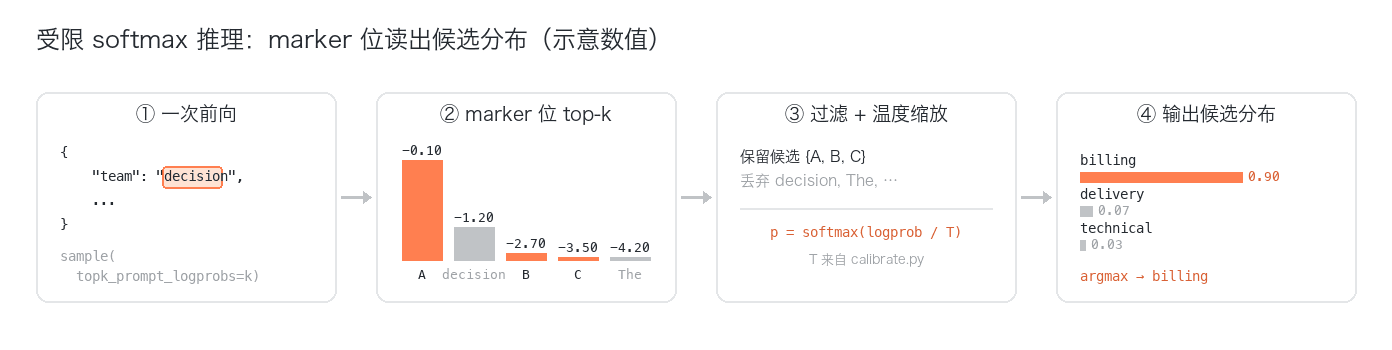
随后 softmax() 与业务输出映射 在当前字段的候选集合内计算:
这里的 T 是本地校准温度。当前请求得到的是全词表 top-k,令 K 等于候选数量无法保证所有候选都在返回结果中;源码对缺失候选使用 min(topk.values()) - 10 近似。因此,这套实现得到的候选分布存在 top-k 截断近似,概率归一化后仍需评估校准质量。
运行训练
使用 训练入口,先用 64 条记录验证数据、marker 对齐和权重保存:
uv run python train.py \
    --max-samples 64 \
    --epochs 1 \
    --batch-size 16 \
    --save-every 0 \
    --swanlab-mode offline
参考运行的正式配置为:
uv run python train.py \
    --epochs 2 \
    --batch-size 16 \
    --save-every 60 \
    --swanlab-mode online
2,160 条记录对应每个 epoch 135 steps,共 270 steps。--save-every 0 只关闭 step 级保存,每个 epoch 结束仍会保存权重。
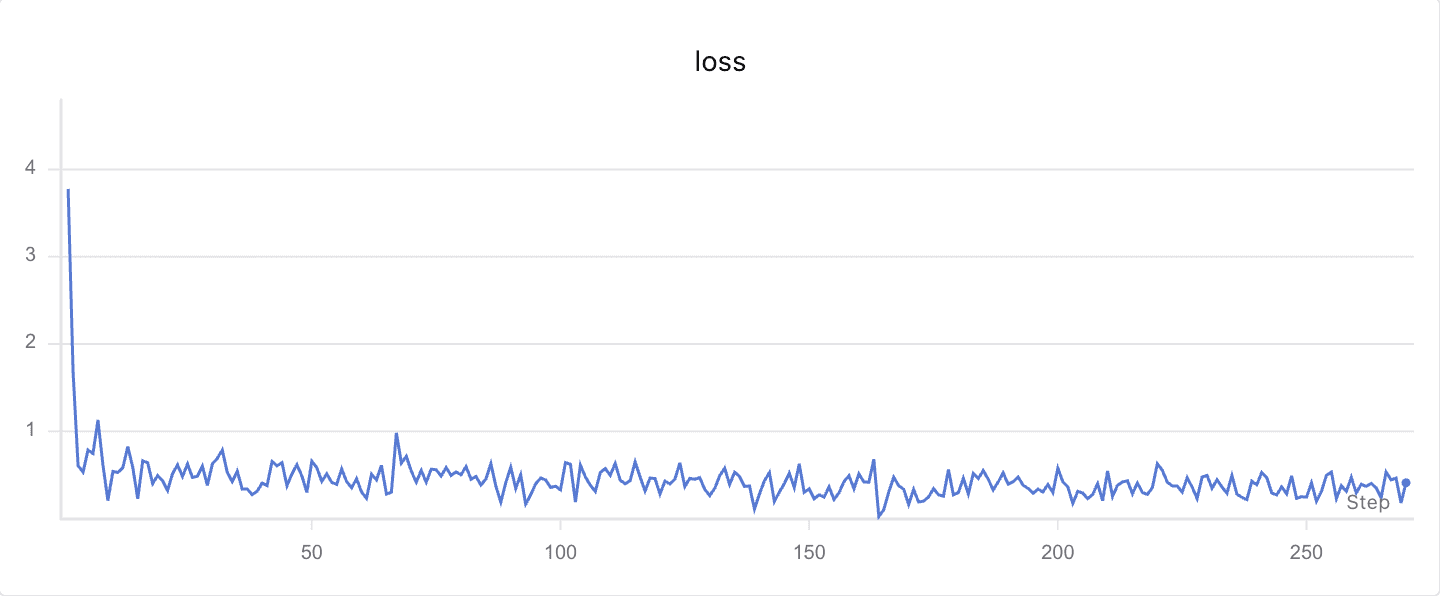
save_weights() 保存并打印 trio://... sampler weights 路径,用于推理、校准和评测;当前脚本没有保存包含优化器状态的 training state。
推理与温度校准
把下面变量替换为训练日志里实际保存的权重路径。运行 推理入口,可检查内置工单样例的三个决策字段:
JEV_WEIGHTS='trio://YOUR_STEP_270_SAMPLER_WEIGHTS'
uv run python inference.py --weights "$JEV_WEIGHTS"
省略 --weights 时使用 Base Model;传入 --input path/to/records.jsonl --limit 3 可读取自定义记录。
接着使用 calibrate.py 在独立 calibration 划分上拟合温度:
uv run python calibrate.py \
    --weights "$JEV_WEIGHTS" \
    --output outputs/calibration.json
实现是在 log T 上做黄金分割搜索,以最小化候选分布的 NLL。参考运行记录的 T ≈ 1.1319,校准集 NLL 从 0.4990 降到 0.4959;复现时应使用自己拟合的温度。
校准文件记录温度、权重路径和 NLL。评测前核对其中的权重路径与待评 checkpoint 一致;当前 evaluator 只读取温度,没有自动校验权重是否匹配。
对固定的同一组候选得分,正温度缩放保持 argmax 不变。校准用来调整概率的置信程度,评测时同时检查 Accuracy、ECE 和 Brier。
五项基准评测
在 checkpoint 和温度确定后,用 eval.py 分别评测 Base、未校准 checkpoint 和校准后的 checkpoint:
uv run python eval.py --tag base

uv run python eval.py \
    --weights "$JEV_WEIGHTS" \
    --tag step-270

uv run python eval.py \
    --weights "$JEV_WEIGHTS" \
    --calibration outputs/calibration.json \
    --tag step-270-cal
脚本默认评测全部五项,结果写入 outputs/eval-<tag>.json。也可以使用 --suite typed_decisions 只运行一项。最后用 analysis.py 汇总:
uv run python analysis.py以下准确率来自 源仓库的参考实验记录:
| 基准 | 决策数 | Base | Step 270 | Step 270 + 校准 |
|---|---|---|---|---|
| Jevbench Easy | 48 | 100.00% | 100.00% | 100.00% |
| Jevbench Original | 72 | 87.50% | 95.83% | 95.83% |
| Jevbench Hard | 111 | 55.86% | 47.75% | 49.55% |
| Typed Decisions test | 2,000 | 50.40% | 79.20% | 79.10% |
| ToolACE | 310 | 87.74% | 94.52% | 94.19% |
| 五项等权平均 | — | 76.30% | 83.46% | 83.74% |
Typed Decisions test 的 2,000 个决策来自 400 条记录。平均值对五项基准等权计算,未按决策数量加权。
校准前后是分别请求得到的评测记录,准确率差异不能直接归因于温度缩放。Hard 的参考 ECE / Brier 从 0.2311 / 0.6510 变为 0.1884 / 0.6331,这也需要结合独立请求的变化阅读。
训练时重点观察
| 指标或检查项 | 作用 |
|---|---|
loss | 按监督位置归一化的交叉熵 |
supervised_tokens | 当前 batch 实际监督的字段数量 |
trainer/* | PyTRIO 返回的训练指标 |
| Accuracy | 按字段统计的决策正确率,需分别看各基准 |
| ECE | 10 个等宽置信度分桶的校准误差,越低越好 |
| Brier | 每个决策的候选概率与 one-hot 标签的平方差之和,再对决策取均值,越低越好 |
| 候选是否进入 top-k | 检查概率近似的影响;当前脚本未自动上报覆盖率 |
Loss 下降只能说明监督目标拟合得更好。参考实验中 Typed Decisions 和 ToolACE 提升,Jevbench-Hard 准确率下降,迁移到业务数据时需要单独保留困难样本和独立测试集。
复现边界
- 本案例实现的是 Jev 风格的固定候选决策流程,使用 Qwen3.5-4B、LoRA 和 PyTRIO;结果来自一次参考训练。
- Typed Decisions 使用 train / test 同 workflow 的 specialist 设置,与其他模型的零样本评测条件不同。
dev划分已保留,当前脚本没有自动选择最优 checkpoint;温度仅在 calibration 上拟合。- 候选符号须为单 token、候选数不超过 62;更换 tokenizer 或模板时需重新校验候选映射、marker 定位及本地/远端输入长度。
- 固定选项分类不能覆盖任意开放式问答。业务上线前应验证自己的数据分布、概率校准和决策阈值。
完整实现与参考运行说明见 源仓库 README。